

Agent Skill 是挂载给智能体的说明文档和配套脚本,用来补充某项任务的做法。SkillsBench(arXiv:2602.12670)是第一个专门评测 Skill 的基准。它的设计很直接:同一道题让智能体做两遍,一遍只给题面,一遍额外挂载人工编写的 Skill,两次通过率之差就是 Skill 带来的增益。论文在 87 道题上测试了 18 种模型与脚手架的组合(下称配置),报告 Skill 把平均通过率从 33.9% 提高到 50.5%,平均增益为 16.6 个百分点。
每道题由四部分组成:题面、判分用的验证器、作者提供的参考解,以及 Skill 目录。我们读完了全部 87 道题的这四部分,再用官方公布的逐题得分,把 16.6 个百分点的平均增益拆到每一道题上。结果是,约 79% 的增益来自两类题:一类的评分规则只写在 Skill 里,题面没有交代;另一类的 Skill 附带了近乎完整的解题脚本。Skill 作为可迁移的知识带来的增益确实存在,约占四分之一。
三道高增益题
先看 sec-financial-report。题目要求解析一份 SEC 13F 持仓文件,其中一问是统计普通股持仓的条数,验证器要求答案恰好等于 2451。无 Skill 时,18 种配置各运行 3 次,54 次无一通过。原因在参考解里。参考解用一份类别名单筛选普通股,名单中段有 15 行漏了逗号:
    "com shs",
    "sponsored adr"
    "sponsored ads"
    "adr"
    "equity"
    ...
    "foreign stock"
    "shs cl a",
]
Python 会把相邻的字符串直接拼接。从 "sponsored adr" 到 "shs cl a" 的 16 个类别因此合成了一条长字符串,名单由 25 项缩为 10 项,这 16 类持仓全部落在名单之外。2451 是这份残缺名单算出的数。Skill 目录里的 one_fund_analysis.py 带着同一份名单,漏掉的逗号也在同样的位置,所以有 Skill 时通过率达到 68.5%。这道题 68.5 个百分点的增益,区分的是智能体有没有拿到作者那份带错的脚本。
第二道是 dapt-intrusion-detection。题目给出一份抓包文件,要求统计流量指标并判断是否存在 DoS 攻击。题面对 DoS 的描述只有“极端的流量尖峰或洪泛式速率”,没有给出判定阈值。验证器里写死的答案是每分钟包数最大 2372、平均 262.9、不存在 DoS。Skill 文档在示例一节写着 ppm_max = 2372, ppm_avg = 262.9,两者之比 9.02 小于 20,结论为 NO DoS。示例中的数值与验证器的答案逐项相同,20 这个阈值也只在这里出现。这道题无 Skill 时通过率为 0,有 Skill 时为 81.5%。论文的入库流程设有一项检查,声明会拒绝含有魔法数字或期望输出的 Skill,这道题没有被拦下。
第三道是 earthquake-plate-calculation。题目要求找出太平洋板块内离板块边界最远的地震,并给出它到边界的距离。题面只说使用 GeoPandas 投影,没有指定坐标系。验证器要求距离为 3878.27 km,容差 0.01 km,也就是 10 米。在几千公里的尺度上,换一种投影或改用椭球测地线,算出的距离通常会相差远不止 10 米。参考解用的坐标系是 EPSG:4087,这个代号在题面里没有出现,在 Skill 里出现了多次,并附有几乎完整的计算代码。通过率从无 Skill 时的 3.7% 升到有 Skill 时的 68.5%。图 1 列出了这道题里各方掌握的信息。
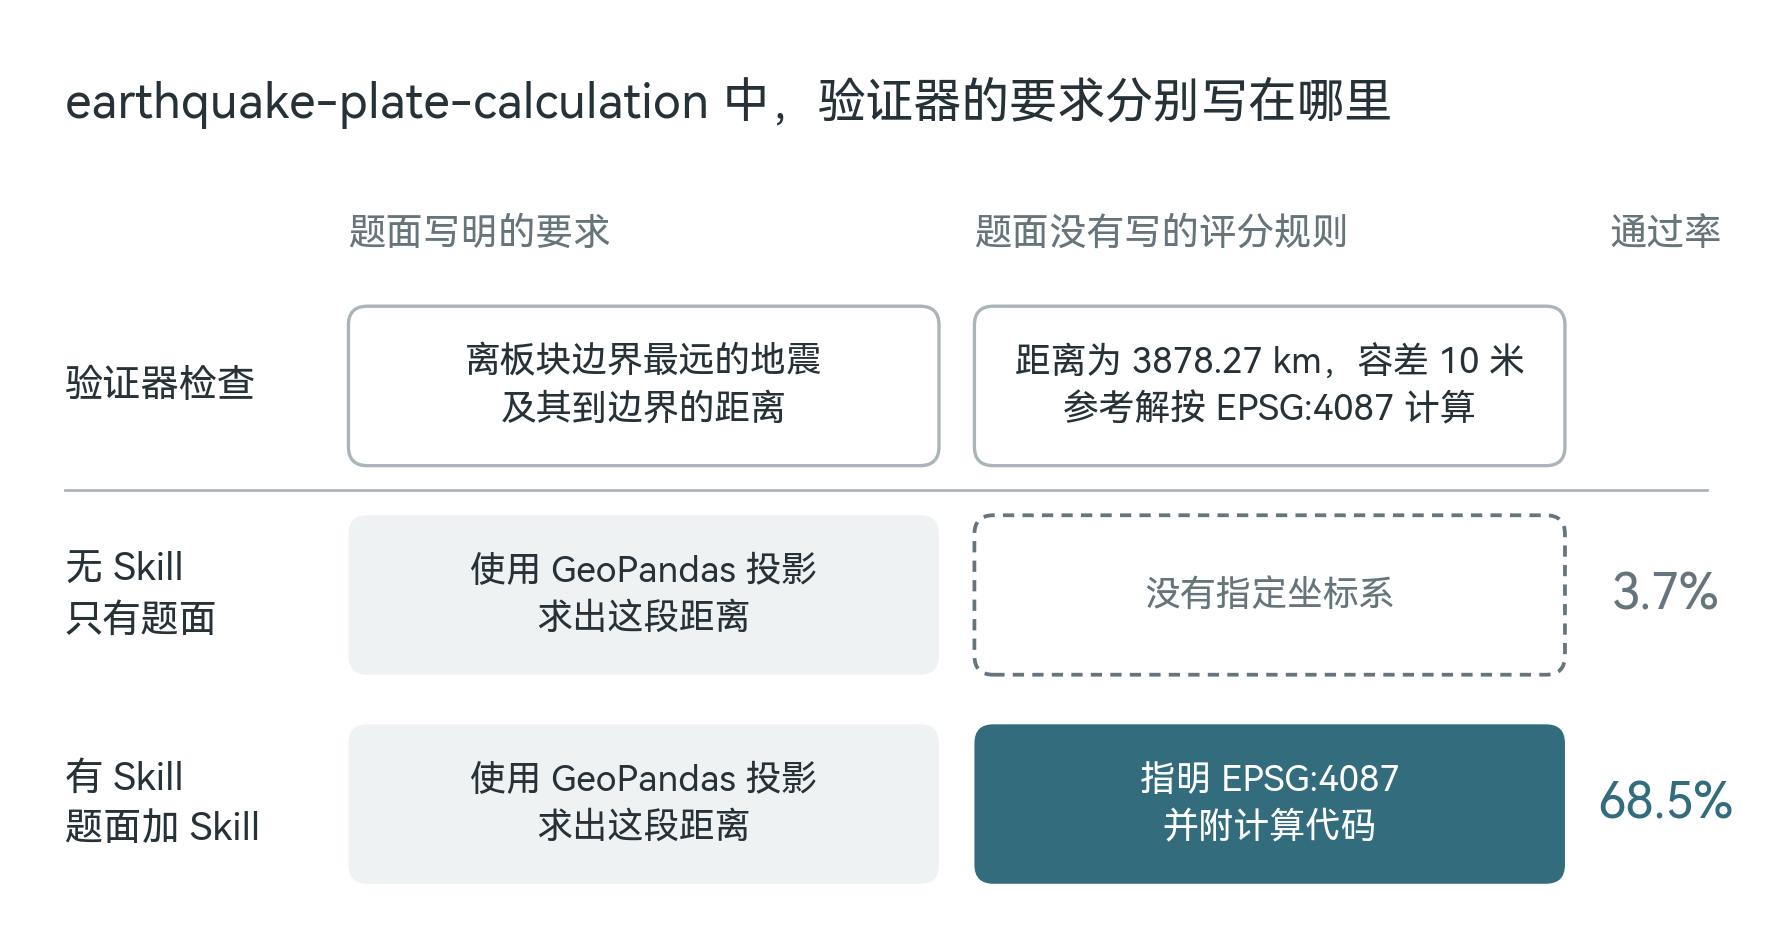
三道题的共同点是,验证器检查的规则没有写在题面里,只写在 Skill 里。下文把这样的规则称为隐藏规则。论文把增益最高的 10 道题列为 Skill 有效的代表,它们的平均增益是 67 个百分点。按我们的标注,其中 9 道的增益主要来自隐藏规则。
16.6 个百分点增益的构成
我们按 Skill 起作用的主要方式把 87 道题分成五类。前四类只依据源码划分,增益不超过 2 个百分点或为负的题单列为最后一类。
平均增益可以按题目线性拆分,一类题对平均增益的贡献等于它的题量占比乘以组内平均增益。以第一类为例,27 道题占题量的 31%,组内平均增益为 33.2 个百分点,两者相乘得 10.3 个百分点,占 16.6 个百分点的 62.1%。下表列出各类题的通过率和组内平均增益,图 2 给出各类题对平均增益的贡献。
| Skill 起作用的方式 | 题数 | 通过率(无 Skill → 有 Skill)与组内平均增益 |
|---|---|---|
| 评分规则只写在 Skill 里 | 27 | 18.4% → 51.6%,增益 33.2 个百分点 |
| Skill 附带近乎完整的解题脚本 | 12 | 57.9% → 78.1%,增益 20.2 个百分点 |
| 工具与库的使用方法 | 17 | 34.0% → 49.6%,增益 15.5 个百分点 |
| 领域方法 | 8 | 48.0% → 59.6%,增益 11.6 个百分点 |
| 无效或起反作用 | 23 | 34.7% → 32.4%,下降 2.2 个百分点 |
| 全部 | 87 | 33.9% → 50.5%,增益 16.6 个百分点 |
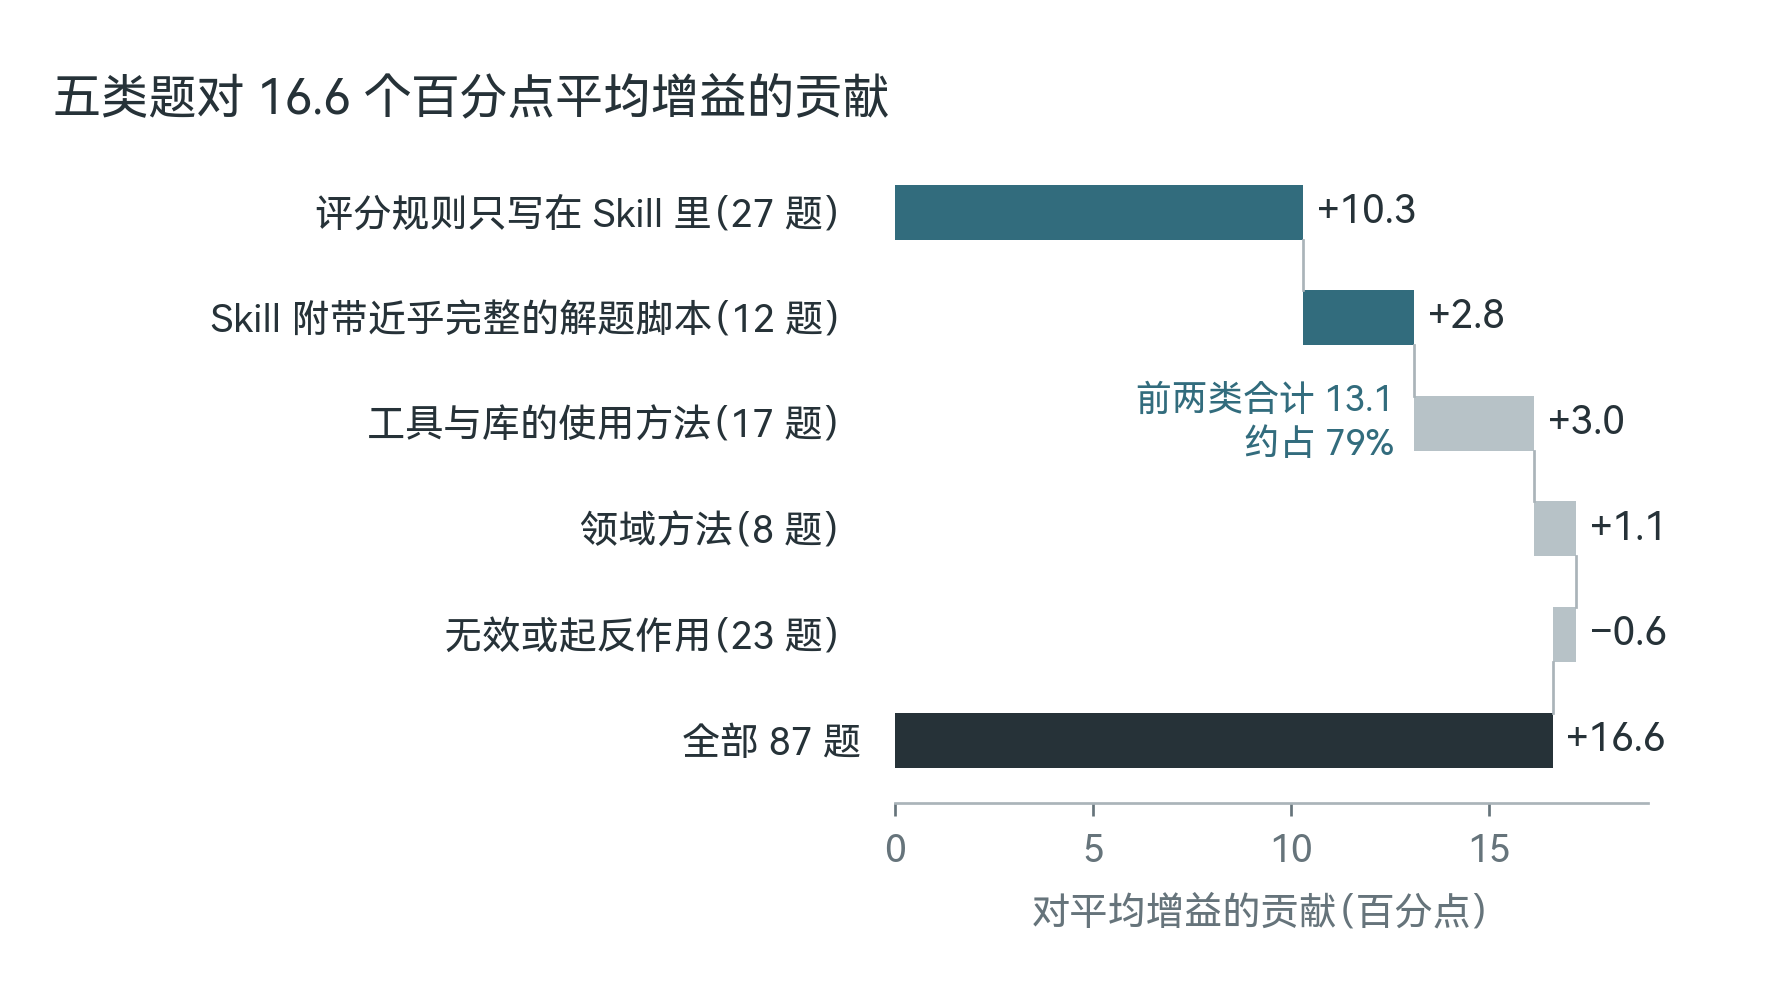
前两类合计 39 道题,占题量不到一半,贡献了 16.6 个百分点中的 13.1 个,约 79%。
第三、四类接近 Skill 的本意。这些 Skill 提醒智能体 openpyxl 保存文件后公式不会重算、需要调用 LibreOffice,或者说明 SeisBench 和 GaMMA 这类地震学工具包的接口。这 25 道题的组内平均增益为 14.3 个百分点,对全部 87 题平均增益的贡献是 4.1 个百分点,约 25%。
最后一类的 23 道题上 Skill 没有帮助,通过率平均下降 2.2 个百分点。
高增益来自被压低的无 Skill 通过率
高增益还有一种可能的解释:这些题本身更难,因而更需要 Skill。按隐藏规则的严重程度把题目分成三档,可以检验这个解释,结果见图 3。重度指按题面做出的合理解法会被验证器判错,轻度指键名、取整方式等细节在题面里有歧义。
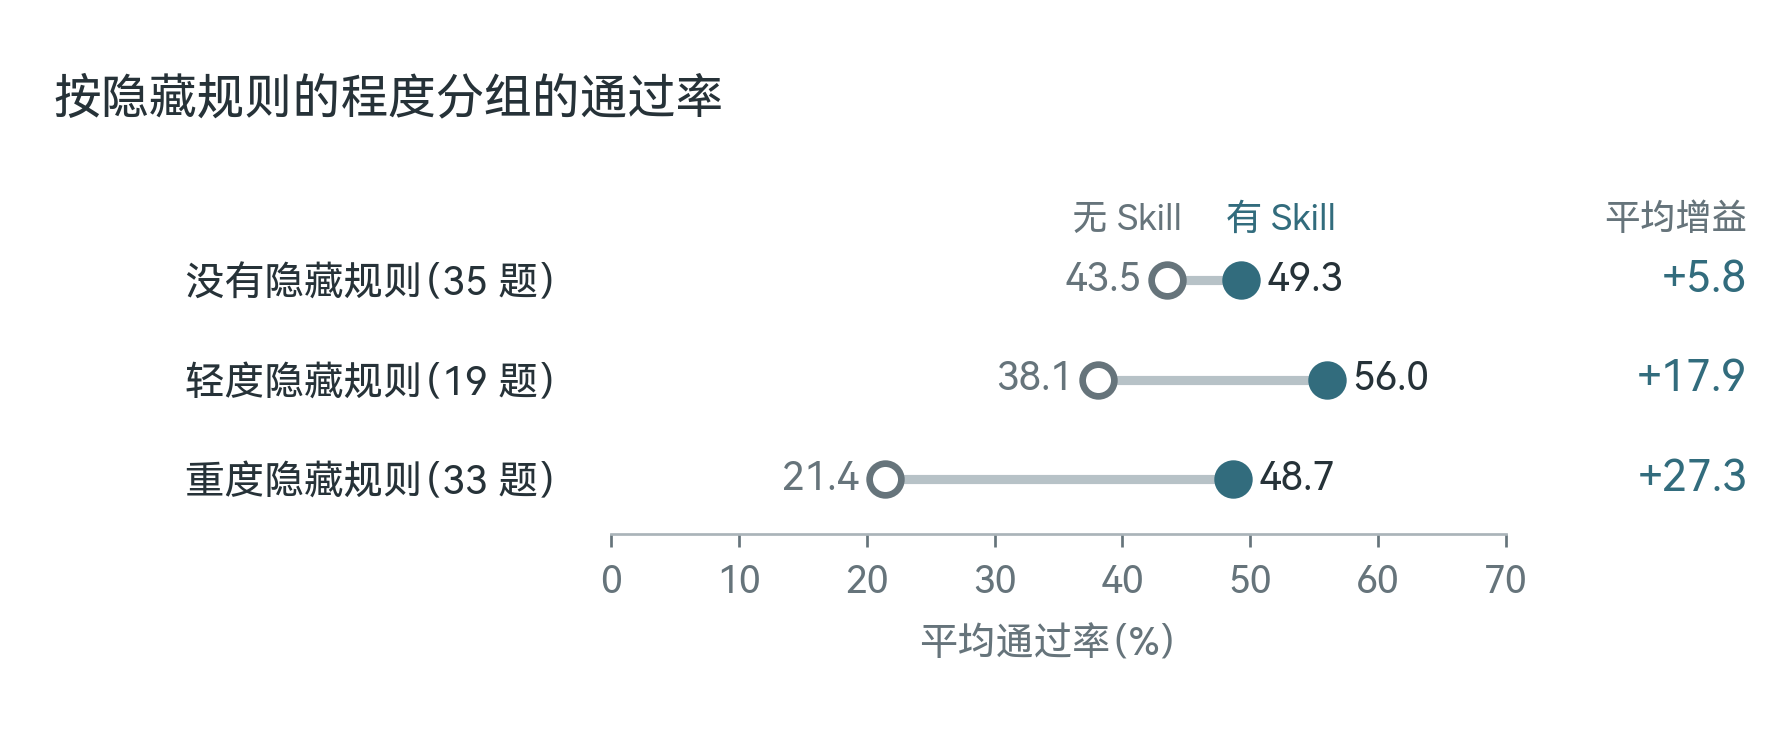
没有隐藏规则的 35 道题和重度隐藏规则的 33 道题,有 Skill 时的通过率几乎相同,分别为 49.3% 和 48.7%。两组的差别集中在无 Skill 时的通过率上,前者为 43.5%,后者只有 21.4%。如果后一组题只是更难,它们在有 Skill 时的通过率通常也会更低。数据呈现的是另一种情形:验证器检查的规则题面没有写,无 Skill 的智能体即使思路正确也很难恰好符合,通过率被压低;Skill 把规则补上之后,通过率回到与其他题相近的水平,两者相减就得到很高的增益。
按 Skill 是否附带代码来分,增益同样集中。35 道题的 Skill 只有文字说明,没有针对本题的代码,它们的平均增益是 1.7 个百分点。其余 52 道题的 Skill 附带代码模板或近乎完整的脚本,贡献了约 96% 的平均增益。
干净子集上的增益
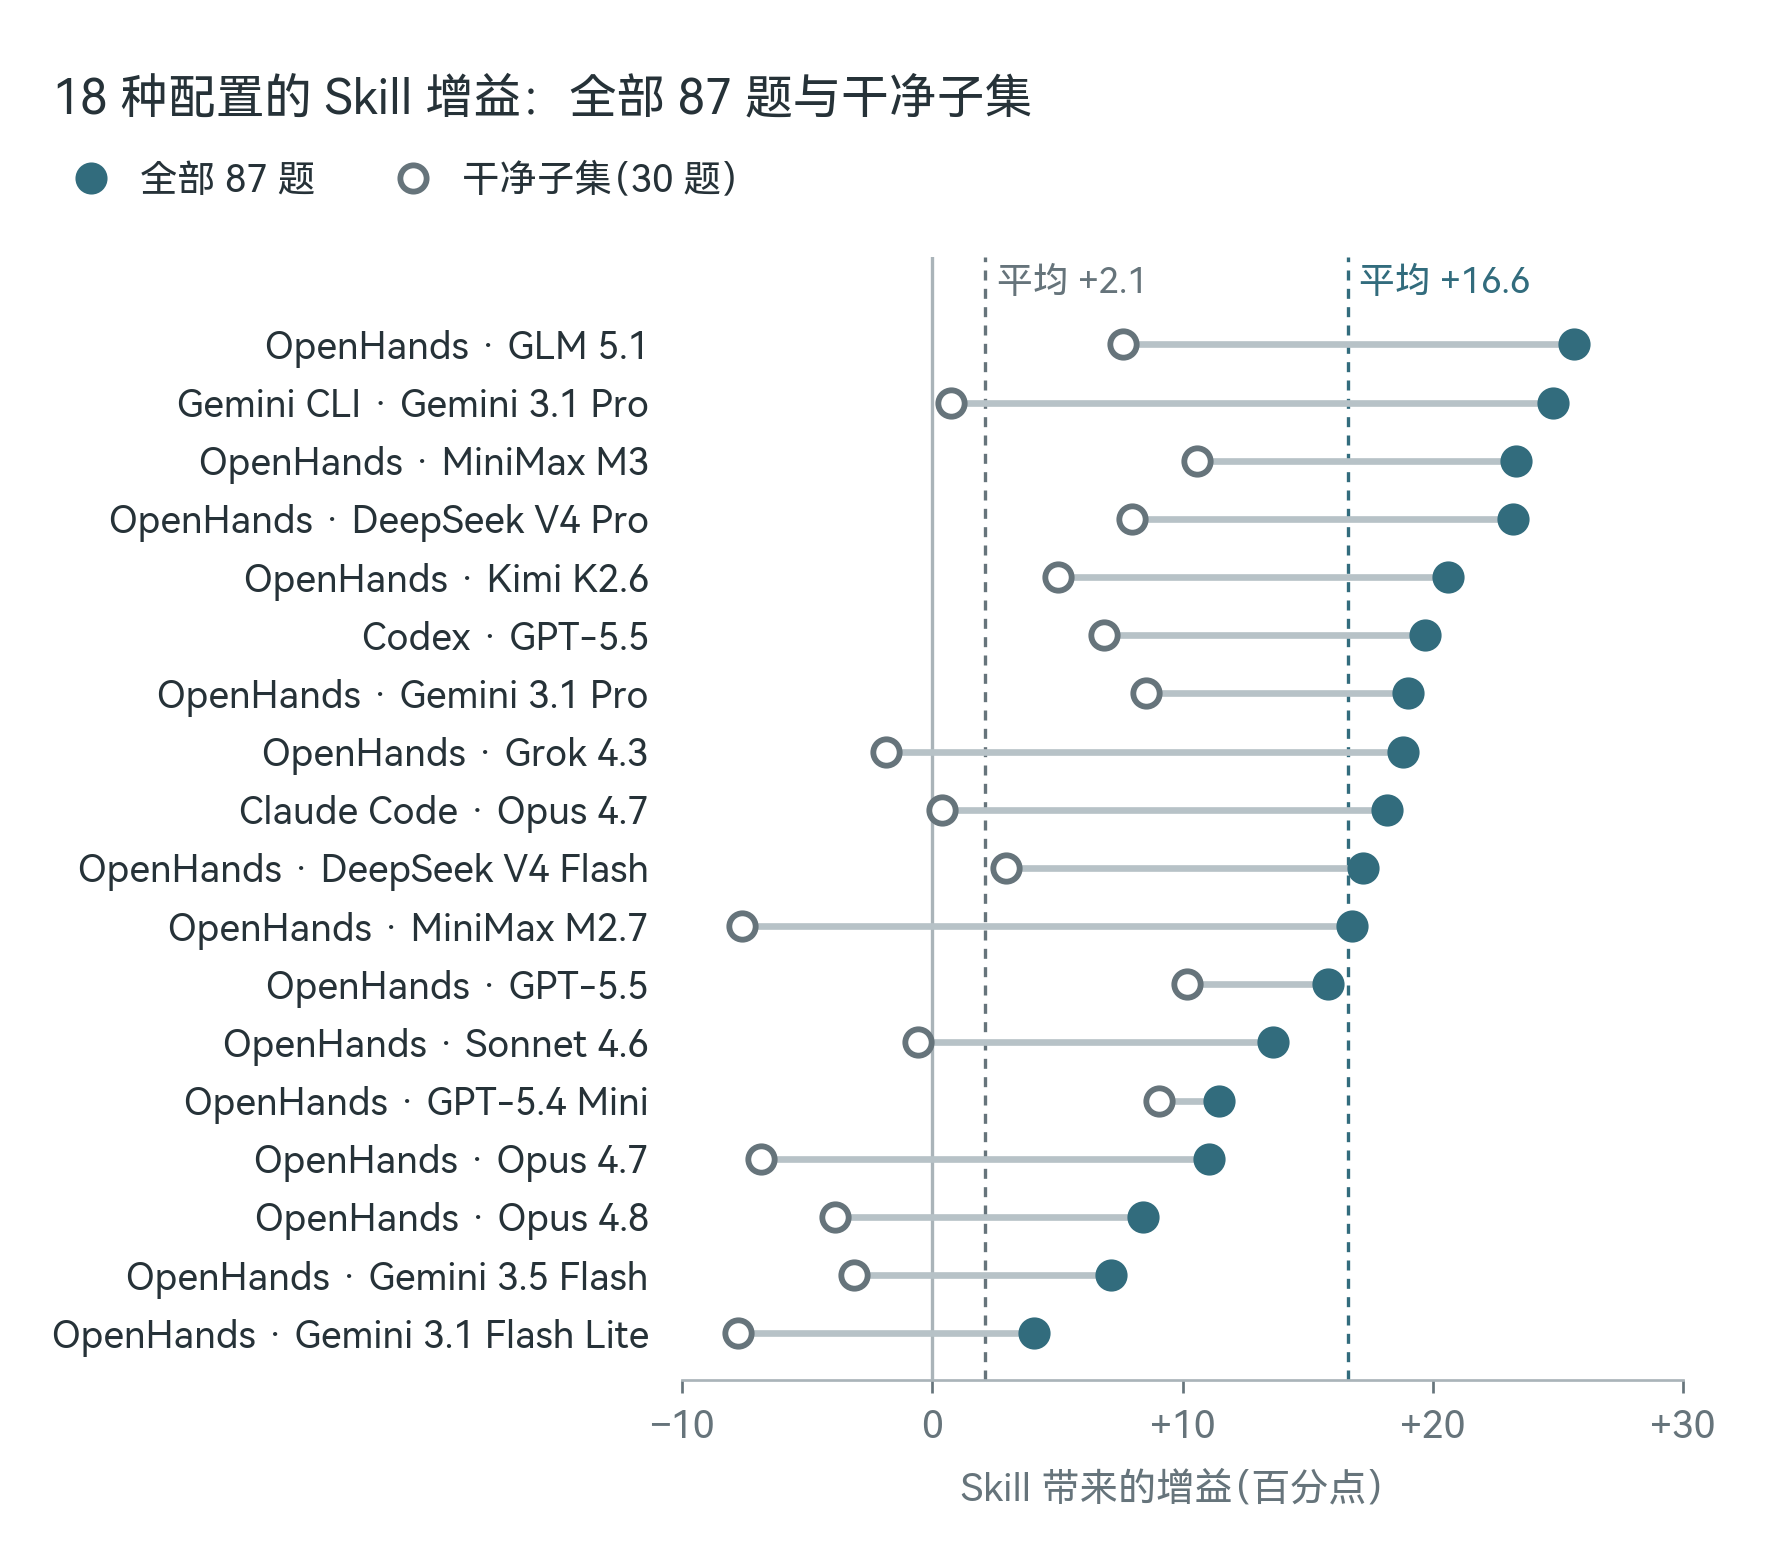
把没有隐藏规则、Skill 也不含近乎完整解法的题挑出来,共 30 道,下称干净子集。在干净子集上,Skill 把平均通过率从 41.9% 提高到 44.0%,平均增益为 2.1 个百分点,约为全部 87 题上的八分之一。
各配置的表现也随之改变,见图 4。在干净子集上,18 种配置中有 11 种的通过率因 Skill 提高,7 种下降。Claude Code 搭配 Opus 4.7 在全部 87 题上的增益是 18.2 个百分点,在干净子集上是 0.4 个百分点;Gemini CLI 搭配 Gemini 3.1 Pro 由 24.8 个百分点变为 0.7 个百分点。如果进一步要求 Skill 不含任何代码模板,剩下 26 道题,平均增益不到 1 个百分点。
领域之间的差异也可以从题目构成得到解释。论文观察到自然科学和媒体制作两个领域的增益最高,分别为 28.8 和 24.1 个百分点,并将其归因于这些领域的程序性知识在预训练中覆盖不足。自然科学的 14 道题中,有 6 道存在重度隐藏规则,6 道的 Skill 附带近乎完整的解法;媒体制作的 5 道题中,这两种情况各占 4 道。
筛题标准与 Skill 写作建议
这种结构与建库流程有关。论文写明,在 400 份候选题中,有 Skill 和无 Skill 两种条件下拉不开差距的题会作为低信号题被剔除。每道题的题面、验证器、参考解和 Skill 又由同一份提交给出。在这样的流程下,一道模型不看 Skill 也能做对的题若要入库,较省力的办法可能是收紧验证器,再把收紧的细节写进 Skill。
论文在讨论部分给 Skill 作者的建议是:“Skill authors should optimize for verifier-facing detail an agent cannot infer, not for completeness.” 意思是 Skill 应当优先写验证器要检查、智能体又无法自行推断的细节。按通常的理解,这样的细节属于题面应当写明的要求。把它放进 Skill 之后,有 Skill 和无 Skill 两种条件比较的内容,就变成了智能体是否看到完整的题目要求。
仓库记录
仓库的提交历史提供了旁证。2026 年 6 月发布前的自检(PR #948)发现,87 道题中有 12 道的参考解交给验证器评分时得 0 分。其中 10 道的原因是参考解直接加载 Skill 目录里的代码,移除 Skill 后无法运行。
7 月 13 日至 15 日,维护者合并了一批修复(PR #1006 至 #1027)。其中 #1006 处理了两道题的验证器。
threejs-structure-parser 要求把三维场景导出为 OBJ 文件,榜单上无 Skill 时通过率为 0,有 Skill 时为 59.3%。原验证器抽取 300 个顶点做比较,几何相同而顶点写法不同的导出会被判为 0 分。维护者把它改为按三角面片比较,再对此前被判错的 158 组导出重新评分,有 Skill 和无 Skill 两种条件下的导出全部通过。
xlsx-recover-data 的验证器期望某个平均值为 7444.4,这个数少算了一个财年,正确值是 7610.3。每道题在榜单上共运行 108 次,即 18 种配置、两种条件各 3 次,这道题无一通过。108 次全部失败的题共有 5 道。
最后一个修复合并 18 分钟后,PR #1028 以 “Restore stable SkillsBench task baseline” 为题,把任务文件恢复到修复之前的版本,修复内容留在一条实验分支上。在我们冻结的 10 月快照中,主分支的验证器仍然期望 7444.4。这样做保住了已发布成绩的可比性,已知的错误也随之留在当前版本里。
结论
Skill 是有用的。在以工具用法和领域方法为主的 25 道题上,它带来了 14.3 个百分点的平均增益。配对比较也是评测 Skill 的合理起点。
SkillsBench 目前的两种条件把两件事合在了一起,一是补全题目要求,二是传授解题方法。较稳妥的做法是增加第三种条件:把输出格式、单位、容差等评分约定写进题面,但不提供方法。Skill 的增益以这种条件下的通过率为起点来计算,补全题目要求的部分就不会算在 Skill 名下。
在此之前,16.6 个百分点的平均增益尚不足以说明 Skill 教会了智能体多少东西。在没有隐藏规则、也不附带近乎完整解法的 30 道题上,平均增益约为 2 个百分点。
参考资料
[1] SkillsBench 论文,arXiv:2602.12670v4。平均通过率与增益见摘要和表 2,筛题流程见第 3 节,领域差异与高增益题见第 5 节,给 Skill 作者的建议见第 6 节。
[2] SkillsBench 代码仓库,标签 v1.1 与 2026 年 10 月的主分支。题面、验证器、参考解、Skill 和文中引用的合并请求均来自该仓库。
[3] SkillsBench 结果数据,提交 37484902 中的 results-registry.json。18 种配置在 87 道题上的逐题得分共 3,132 条记录,每条为 3 次运行的平均。